ー この記事の要旨 ー
- 意思決定インテリジェンスは、データとAIに人の判断を組み合わせる考え方で、BIの報告やAIによる予測と違い、何を決めるかと決めた後の振り返りまでを扱います。
- 判断の置き場所は、反復頻度・複雑性・1回あたりの影響の3つの問いで、支援・拡張・自動化に振り分けられます。需要予測や与信審査の例でも、判断ごとに置き場所は分かれます。
- まずはチームの判断を書き出して1つを選び、置き場所の仮説を立て、判断の理由と結果を記録していきます。結果だけで判断の良し悪しを決めないこの習慣が、AIへの過信を防ぐ最初の一歩になります。
意思決定インテリジェンスは「何を決めるか」から始まる
意思決定インテリジェンス(Decision Intelligence)とは、データとAIに人の判断を組み合わせ、結果の評価から決め方を改善し続ける考え方です。
BIが報告、AIによる予測が見通しを出すのに対し、意思決定インテリジェンスは決定と、その結果の振り返りまでを扱います。需要予測や与信審査などの現場では、どの判断をどこまで機械に任せるかを決める枠組みとして使われています。
ガートナーの定義では「振り返り」までが含まれる
この言葉を広めたのは、米国の調査会社ガートナー(Gartner)です。
ガートナージャパンは、2025年9月に発表した「先進テクノロジのハイプ・サイクル:2025年」で意思決定インテリジェンスを取り上げています。そこでの説明は、意思決定のやり方と、結果の評価・管理のしかた、フィードバックによる改善のしかたを確立することで、意思決定を高度化する実践的な手法というものです。
注目したいのは、定義に「結果の評価」と「フィードバックによる改善」が入っている点です。分析して終わり、決めて終わりではありません。決めた後に結果を確かめ、次の決め方に戻すところまでを、一つの仕組みとして扱います。
ガートナーは、AIやアナリティクスを意思決定に取り入れる度合いを「支援」「拡張」「自動化」の3段階でも整理しており、この区分が自社の判断に当てはめるときの骨格になります。日本語の資料では、「拡張」が「強化」と訳されることもあります。
提唱者はロリエン・プラット、DIPとは別物
概念の出自は、AIと機械学習の分野の先駆者として知られるロリエン・プラット(Lorien Pratt)氏にさかのぼります。
プラット氏は2019年の著書『Link』で、AIの先にあるものとして意思決定インテリジェンスを取り上げました。経済学や最適化、心理学、シミュレーションなどの領域と、人の意思決定者を結びつける考え方として論じています。
混同しやすいのが、意思決定インテリジェンス(考え方)とDIP(意思決定インテリジェンス・プラットフォーム)の違いです。
ガートナーのマジック・クアドラントでは、DIPは、データ・アナリティクス・知識・AIを組み合わせて、人や機械の意思決定を支援・拡張・自動化する仕組みをつくるソフトウェアと位置づけられています(SASの解説による)。
DIPは、考え方を実装するための道具です。DIPを導入していなくても、意思決定インテリジェンスの考え方で業務の判断を見直すことはできます。
なお、カタカナで「デシジョン・インテリジェンス」と表記されることもありますが、指している概念は同じです。
「分析はあるのに決まらない」が出発点
ダッシュボードやレポートは増えたのに、会議で結論が出ない。決めた後に、誰も結果を振り返らない。こうした「分析はあるのに決まらない」状態から抜け出すための考え方が、意思決定インテリジェンスです。
ガートナーの2025年版ハイプ・サイクルでは、意思決定をデジタル化して資産としてモデル化し、インサイトから行動に至るまでのギャップを埋めて、意思決定の質や成果を継続的に高めるものとして紹介されています(Publickeyの紹介記事)。
判断そのものが複雑になっていることも背景にあります。ガートナーが2021年に公開した記事では、関係者や選択肢が増えた結果、2年前と比べて65%の意思決定が複雑になったという同社の調査が紹介されています。
勘と経験だけに頼る判断には、思い込みや偏りも入り込みます。人の判断に偏りが生まれるしくみは、関連記事『認知バイアスとは?』で詳しく解説しています。
意思決定インテリジェンスで成否を分けるのは、分析の高度さよりも、「どの判断を、誰が、何を根拠に下し、結果をどう振り返るか」を先に決めているかどうかです。起点に置くのは、データではなく判断です。
何を組み合わせて判断の質を上げるのか
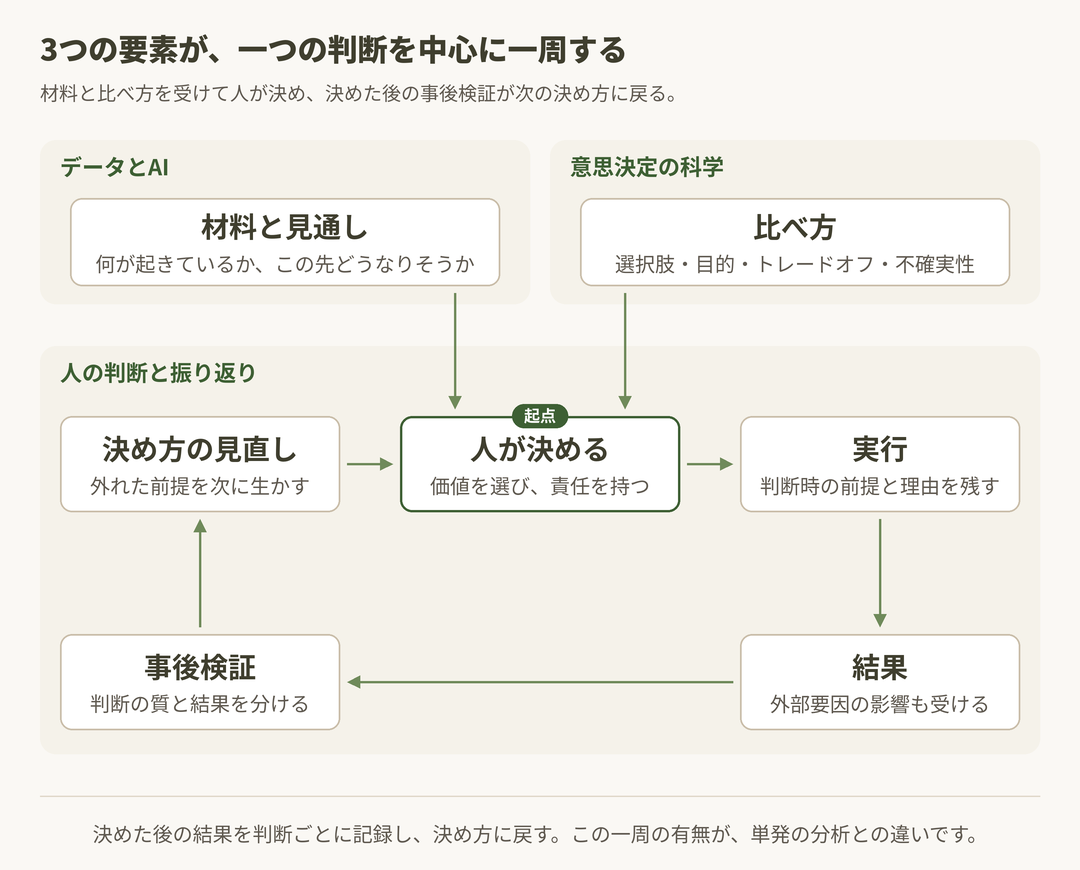
意思決定インテリジェンスは、データとAI、意思決定の科学、人の判断と振り返りの3つを、一つの判断のために組み合わせます。どれか一つが欠けると、仕組みとして回りません。
データとAIが担うのは「材料」と「見通し」
データ/アナリティクス(D&A)は、過去と現在に何が起きているかを示す材料です。AIや機械学習は、その材料から「この先どうなりそうか」を見積もり、選択肢ごとの結果を比べられるようにします。
ただし、材料と見通しがそろっても、それだけでは何も決まりません。在庫が減る見通しが出ても、発注量をいくつにするか、誰が承認するかは別の問いだからです。
意思決定の科学が「比べ方」を与える
意思決定理論や経営科学、行動経済学といった意思決定の科学は、選択肢の比べ方を与えます。選択肢を並べ、目的とトレードオフを明らかにし、不確実性をどう扱うかを決めるための知見です。
プラット氏は、この部分を可視化する手法として因果意思決定図(CDD:Causal Decision Diagram)を用いています。CDDは、選択肢、成果、目標、外部要因や制約、因果関係、中間的な結果を1枚の図にまとめ、複雑な判断を関係者が一緒に組み立てるための道具です(The Uncertainty Projectの解説)。
身近な例でいえば、「値引きをするか」という判断です。選択肢(値引き率)から中間結果(来店数や客単価)を経て成果(粗利)に至る線を引き、そこに外部要因(天候や競合の動き)を書き加えます。
プラット氏自身も、行動から成果に至る道筋の途中にこそ、データや機械学習モデル、統計が収まると説明しています。
人の判断と振り返りで一周する
人の判断と振り返りは、仕組みを一周させる最後の要素です。どれだけ分析が高度でも、何を優先するかという価値の選択と説明責任は人が担います。
決めた後の結果を記録し、次の判断に戻す。この循環があるかどうかが、単発の分析プロジェクトとの大きな違いです。
3つの要素が一つの判断の中でどうつながるかを1枚にまとめると、次の図のようになります。
データ分析と何が違う?
BIは何が起きたかを報告し、AIによる予測はこの先どうなるかを示し、意思決定インテリジェンスは何を決めるかまでを扱います。違いは、出力が「報告」「予測」「決定」のどれにあたるかという一点に集約できます。
報告・予測・決定で比べる
| 比べる点 | BI(ビジネスインテリジェンス) | AIによる予測 | 意思決定インテリジェンス |
| 出力するもの | 報告(過去と現在の状況) | 予測(この先の見通し) | 決定(何をするかと、その根拠) |
| 答える問い | 何が起きたか、なぜ起きたか | 次に何が起きそうか | 何をすべきか、その判断は妥当だったか |
| 主に使う分析 | 記述的分析・診断的分析 | 予測分析 | 予測分析・処方的分析に、意思決定の設計と事後検証を加える |
| 決めた後の扱い | 結果の数字は映すが、どの判断の結果かまではつなげない | 予測と実績のずれは測るが、判断の良し悪しは扱わない | 結果を判断ごとに記録し、決め方の見直しに戻す |
表では出力を一語で区別していますが、意思決定インテリジェンスが予測を使わないわけではありません。決定を届けるための材料として、予測分析も処方的分析も使います。
用語を補足しておきます。BIは、過去と現在の状況を見える化する仕組みです。記述的分析は「何が起きたか」を、診断的分析は「なぜ起きたか」を明らかにします。予測分析はこの先どうなるかを見積もる分析、処方的分析は何をすべきかを示す分析です。
データ分析は否定されず、部品として含まれる
意思決定インテリジェンスは、データ分析に取って代わる新技術ではありません。データ分析を部品として含み、判断を単位に組み立て直す考え方です。
BIのダッシュボードも予測モデルも、そのまま使い続けます。変わるのは、それらを「どの判断のために使うのか」から逆算して並べ直す点です。
最も近い処方的分析との違いも、この包含関係で説明できます。処方的分析は、分析から「何をすべきか」の推奨を導く手法です。意思決定インテリジェンスは、その推奨を誰がどう採否し、実行後の結果をどう決め方に戻すかまでを設計します。
営業部門の例で考えてみます。BIが「東日本エリアの売上が前月から落ちている」と示し、予測モデルが「来月も需要は弱い」と見積もったとします。ここまでがデータ分析です。
意思決定インテリジェンスが加わると、「販促費をどのエリアに振り向けるか」「その判断は誰が下し、いつ結果を確かめるか」「外れたときはどの前提を疑うか」までが設計の対象になります。
意思決定支援システム(DSS)やデータドリブン経営との関係
意思決定を情報システムで支えるという発想自体は、新しいものではありません。意思決定支援システム(DSS)は、経営者や管理職の判断を支える仕組みとして長く研究・導入されてきました。
意思決定インテリジェンスはその延長線上にありますが、AIによる拡張・自動化と、結果からの改善までを一つの枠組みに含めた点が異なります。
データドリブン経営は、「データに基づいて判断する」という経営の姿勢を指します。これに対し、意思決定インテリジェンスは、その判断を具体的にどう設計し、どう振り返るかという方法です。姿勢と方法の関係にあるため、両者は対立しません。
支援・拡張・自動化はどう違う?
3つの違いは、最後に誰が決めるかと、使う分析の種類にあります。支援は人が決め、拡張はAIの推奨を受けて人が決め、自動化はシステムが決めます。
ガートナーの整理を表にすると、次のとおりです。
| 段階 | 最後に決めるのは | 主に使う分析 | 向いている判断の目安 |
| 支援 | 人 | 記述的分析・診断的分析・予測分析 | 状況が複雑で、急ぐ必要がない判断 |
| 拡張 | 人(AIの推奨を受けて) | 予測分析・処方的分析 | 専門知識が要り、数分から数時間で決める判断 |
| 自動化 | システム | 予測分析・処方的分析 | 単純で、数秒から15分程度で決める判断 |
表の目安は、ガートナーが「時間」と「複雑性」の2つから示したものです。同社は、自動化は数秒から15分以内に下す必要がある単純な判断に、拡張は難しい判断や数分から数時間で下す判断に向くとしています。支援は、複雑または混沌とした状況で、緊急性のない判断に向くという整理です。
3段階は成熟度ではなく「置き場所」
よくある誤解は、支援から拡張、拡張から自動化へ進むほど優れているという見方です。実際には、3段階は優劣ではなく、判断ごとの置き場所の違いです。
M&Aのように数か月かけて決める判断は、どれだけAI活用が進んだ組織でも支援に置くのが自然です。
一方で、置き場所は固定でもありません。ガートナーは、技術の進歩とともに、自動化できる範囲が複雑性の方向へ広がっていくと見ています。今は拡張に置いている判断も、実績が積み上がれば一部を自動化へ移す余地があります。
AIエージェント・生成AIとの関係
ガートナーは、AIエージェントを、デジタルや現実の環境で状況を知覚し、意思決定を下して行動を起こし、目的を達成するものと説明しています。意思決定インテリジェンスから見ると、AIエージェントは自動化された意思決定を実行する主体にあたります。
どの判断をエージェントに任せ、どの条件で人に戻すかを決めるのが、意思決定インテリジェンスの役割です。任せる範囲が広がるほど、任せる前の設計が重みを増します。
生成AIは、情報の要約や選択肢の洗い出しなど、主に支援や拡張の場面で力を発揮します。AIエージェントの仕組みそのものを確認したい場合は、関連記事『AIエージェントとは?』を参照してください。
拡張と自動化の境目は「人の介入点」で決まる
拡張と自動化の差は、人がどこで判断に関わるかにあります。推奨を人が承認するのか、例外のときだけ人に回すのか、事後に抜き取りで確認するのかによって、同じAIでも性格が変わります。
最終判断に人が関わる仕組みは、ヒューマン・イン・ザ・ループ(ヒューマンインザループ)と呼ばれます。介入点の置き方を具体的に設計する段階にある場合は、関連記事『ヒューマンインザループとは?』を参照してください。
自社のどの判断を、どの段階に置けばいい?
置き場所は、その判断がどれだけ繰り返されるか、どれだけ込み入っているか、1回外したときの影響がどれだけ大きいか、の3つの問いで見当がつきます。
この3つの問いは、ガートナーが示す時間と複雑性の見方をもとに、実務で当てはめやすいよう反復頻度と1回あたりの影響を加えて組み直した整理です。ガートナー自身の分類ではありません。
3つの問いで置き場所の見当をつける
- 反復頻度:その判断は1日に何度も起きるのか、年に数回なのか。頻度が高いほど、人が毎回考えるコストが積み上がり、拡張や自動化の効果が大きくなります。
- 複雑性:判断基準を言葉やルールで書き出せるか。書き出せるなら自動化の候補になり、例外や解釈の余地が多いなら人が関わる形が向きます。
- 1回あたりの影響:1回外したとき、どれだけの損失や信用の毀損が起きるか。影響が大きいほど、最終判断を人に残す意味が大きくなります。
3つの答えを組み合わせると、置き場所の見当は次の表でつきます。
| 反復頻度 | 判断基準を書き出せるか | 1回外したときの影響 | 置き場所 | 判断の例 |
| 高い | 書き出せる | 小さい | 自動化 | 売れ行きが安定した定番品の補充発注 |
| 高い | 書き出せる | 大きい | 拡張(閾値で一部を自動化) | 与信審査 |
| 中程度 | 例外が多い | 中程度から大きい | 拡張 | キャンペーン対象の選定 |
| 低い | 書き出しにくい | 大きい | 支援 | 給与決定、M&A |
高頻度・低インパクトの判断を自動化に回すと、人は低頻度・高インパクトの判断に考える力を残せます。意思決定インテリジェンスの効果は、任せた判断そのものだけでなく、この配分の変化にも表れます。
迷ったら影響の大きさで線を引く
3つの問いの答えが割れるときは、影響の大きさを優先します。
与信審査のように件数が多く、1件ごとの影響も小さくない判断では、全件を一律に自動化するより、金額やリスクスコアで線を引く「自動化の閾値設定」が現実的です。閾値より下は自動で決め、上は人が推奨を確認して決めます。
線を引いた後は、オーバーライド率、つまり人がAIの推奨を覆した割合を見ておきます。
覆す割合が高すぎるなら、モデルやルールが現場の実態と合っていない可能性があります。逆にほぼゼロなら、人が中身を確かめずに承認しているだけかもしれません。どちらも、閾値や介入点を見直すきっかけになります。
意思決定の棚卸しから始める
問いを当てはめる前に、そもそもどんな判断があるのかを書き出します。これを意思決定の棚卸し(意思決定インベントリ)と呼びます。
- チームや部署で日常的に下している判断を書き出す(「発注量を決める」「値引きを承認する」のように動詞で書く)
- 判断ごとに、決めている人(意思決定オーナー)、頻度、1回あたりの影響を書き添える
- その判断の基準を言葉にできるかを確かめ、できないものには印をつける
- 3つの問いに照らし、支援・拡張・自動化のどこに置くかの仮説を立てる
判断基準の言語化ができない判断は、自動化の候補から外すのが基本です。基準が言葉にならないまま自動化すると、なぜその結論になったのかを誰も説明できなくなるからです。
候補が多く、どれから手をつけるかを比べて決めたいときの具体的な手順は、関連記事『意思決定マトリクスとは?』にまとめています。
どんな場面で使われている?
活用例を見るときは、業界名よりも、その判断が支援・拡張・自動化のどこに置かれているかに注目すると、自社への当てはめ方が見えてきます。同じ業界の中でも、判断ごとに置き場所は分かれます。
需要予測・在庫最適化:拡張を軸に、定型の補充は自動化へ
需要予測は、意思決定インテリジェンスが語られるときの代表的な領域です。
典型的には、AIが商品ごとの需要と推奨発注量を出し、担当者が販促予定や季節要因を加味して確定する拡張の形から始まります。売れ行きが安定した定番品の補充は、ルールと閾値を決めたうえで自動化へ移しやすい判断です。
一方、供給網全体が乱れる局面は事情が違います。ガートナーは、サプライチェーンの混乱を、関係性や相互依存が複数からみ合い、判断の波及をシミュレーションで確かめる必要がある「複雑系」の例に挙げています。
こうした局面では、自動化された発注をいったん止め、人が複数のシナリオを比べて決める支援に戻す設計が求められます。
与信審査・不正検知:定型は自動化、境界は人へ
件数が多く、基準をスコアやルールで表しやすいのが与信審査や不正検知です。スコアが明確に良い案件や明確に悪い案件は自動で処理し、境界付近の案件や例外だけを担当者に回す形が典型です。
ガートナーも、保険金詐欺を、原因と結果を見極めるのに専門知識や分析が要る「困難系」の判断の例に挙げています。
過去の審査結果を学習に使う場合は、そのデータに含まれる偏りまで引き継ぐ点に気をつけます。
価格最適化・マーケティング:拡張と自動化が混在する
価格や販促の判断は、段階が混在しやすい領域です。
ECの価格調整のように頻度が高く、上限と下限を決められる判断は自動化に向きます。一方、キャンペーンの対象や施策の選定は、AIが候補と見込みを示し、担当者が選ぶ拡張に置かれることが一般的です。ガートナーはマーケティング・キャンペーンも「困難系」の例として挙げています。
人事・給与:支援に置かれやすい判断
人事や給与は、支援に置かれやすい代表例です。ガートナーは給与決定について、緊急性がなく数日から数週間の猶予があるため、多くは「支援」の区分に入ると整理しています。
評価される人の納得感や説明責任が重く、判断基準を一律のルールにしにくいことも理由です。
活用例を読むときは、製品紹介に載る削減率や改善率を、そのまま自社に当てはめないことも大切です。そうした数字は特定の企業の条件で出た結果であり、判断の置き場所やデータの状態が違えば効果も変わります。
うまくいかないのはどんなとき?
意思決定インテリジェンスのつまずきは、道具の性能よりも、問い・データ・振り返りのどこかが抜けているときに起きやすくなります。いずれも、導入前に確かめられるものです。
問いを決めずにデータを集める
代表的なのが、どの判断に使うかを決めないまま、データ収集と分析から始めてしまうパターンです。
プラット氏は、データの収集と分析を先に立てて判断に臨むと、手元にあるデータが判断の枠組みを決めてしまい、集めたデータの多くが判断の主要な要素と無関係になると指摘しています(The Uncertainty Projectの解説)。
対策は、順序を逆にすることです。まず判断と、その判断で得たい成果を決め、そのうえで必要なデータを洗い出します。因果意思決定図は、この順序を守るための道具でもあります。
偏った過去データで学習する
AIによる予測や推奨は、学習に使った過去データの傾向を引き継ぎます。過去の採用や融資の判断に偏りがあれば、AIはそれを「正解」として学び、同じ偏りを速く、大量に再現します。
学習に使う前に、そのデータがどんな判断の結果として残ったものかを確かめることが欠かせません。過去に審査の対象にすらならなかった層はデータに現れないため、偏りに気づきにくい点にも目を向けます。
決めた後に結果を検証しない
定義に振り返りが含まれているにもかかわらず、実務で抜けやすいのが意思決定の事後検証です。ここで押さえるべきは、判断の質と結果を切り分けることです。
良い判断をしても、外部要因で悪い結果になることはあります。逆に、根拠の薄い判断が偶然うまくいくこともあります。結果だけで判断を評価すると、運に左右された教訓を学んでしまいます。
そのため、判断した時点の前提・選択肢・理由を記録しておき、結果が出た後に「当時の情報で妥当な判断だったか」と「前提のどこが外れたか」を分けて確かめます。別の選択をしていたらどうなったかという反実仮想の問いも、判断の質を確かめる手がかりになります。
AIの推奨をそのまま通してしまう
拡張の段階で起きやすいのが、人がAIの推奨を確かめずに承認してしまう状態です。自動化バイアス(AIへの過信)と呼ばれる問題に近いものです。
ラジャ・パラスラマン氏とビクター・ライリー氏は1997年の論文で、自動化への過度な依存が監視の失敗や判断の偏りにつながりうると論じています。
人が関わっているはずの判断が実質的に自動化と変わらなくなると、説明責任の所在もあいまいになります。オーバーライド率がほぼゼロに張りついていないか、推奨を承認するときに理由を一言残す運用になっているかを見ておくと、形だけの承認を防ぎやすくなります。
導入前によく出る疑問
導入は何から始めればいい?
意思決定の棚卸しで書き出した判断の中から、最初は1件だけを選びます。選ぶ目安は、頻度が高いこと、基準を言葉にしやすいこと、外しても取り返しがつくことです。
試す期間は、あらかじめ区切っておきます。成果を何で測るか、いつ誰が結果を振り返るかを先に決めておくと、続けるか見直すかの判断がしやすくなります。
必要なデータ・人材・ツールは?
データは、判断の材料になるものに加えて、「どの判断の結果か」を追える記録が必要です。見落とされやすいのは、こちらの記録です。
人材は、判断に責任を持つ意思決定オーナー、データや予測モデルを扱う担当者、現場の事情を知る実務担当者の3者がそろうことが前提になります。専任のデータサイエンティストがいなくても、BIツールや既存の予測機能から始めることはできます。
ツールには、BIツールや予測モデルのほか、判断基準をルールとして管理するビジネスルール管理システム(BRMS)、意思決定モデルを記述する標準のDMN(Decision Model and Notation、意思決定モデルと表記法)などがあります。これらをまとめて扱う製品がDIPです。
主要なプラットフォームやベンダーは?
ガートナーは2026年1月26日付で、DIPを対象とした初のマジック・クアドラントを公表しました。リーダーの条件としては、意思決定のモデル化、オーケストレーション、モニタリング、ガバナンスといった意思決定のライフサイクル全体にわたる能力が挙げられています(SASの発表による)。
リーダーに位置づけられたと発表している企業には、SAS、FICO、Aera Technology、Quantexaなどがあります。これは2026年1月時点の評価であり、今後の改訂で位置づけが変わる可能性があります。
製品を比べる前に、置きたい判断と段階を決めておくと、比較の軸がぶれにくくなります。
効果はどう測ればいい?
投資対効果(ROI)は、「1判断あたりの改善価値×年間の判断回数」で便益を概算し、導入と運用のコストを差し引いて見積もります。1判断あたりの改善価値とは、判断が良くなったときに1回で増える利益や減る損失のことです。
あわせて、意思決定の速さと質も追います。速さは、状況の変化に気づいてから行動するまでの時間(意思決定レイテンシー)で測れます。
質は、事後検証で「当時の情報で妥当だった」と確認できた判断の割合や、オーバーライド率の推移で見ていきます。結果の数字だけで効果を判断しないことが、ここでも前提になります。
AIに任せた判断の責任は誰が負う?
判断を自動化しても、業務上の責任や説明責任までAIに移せるわけではありません。責任は、その判断を設計し、運用を任された人や組織に残ります。
そのため、判断ごとに意思決定オーナーを決め、どの条件で人に戻すか、誰が閾値を変えられるかを明文化しておきます。これが、ガバナンス(決め方のルールと管理体制)の土台になります。
まとめ
意思決定インテリジェンスは、データ分析やAIを手放して新しい道具に乗り換える話ではありません。報告するBIと予測するAIを部品として含み、何を決め、誰が決め、結果をどう振り返るかまでを設計する考え方です。
自社の判断に当てはめるときは、反復頻度・複雑性・1回あたりの影響の3つの問いで、支援・拡張・自動化の置き場所を決めます。迷ったら影響の大きさを優先し、自動化するなら閾値と人に戻す条件を先に決めておきます。
最初の1週間でできることは、次の3つです。
- 自分のチームで繰り返している判断を書き出し、決めている人と頻度を添える
- そのうち1つを選び、3つの問いで置き場所の仮説を立てる
- 選んだ判断について、判断した理由と結果を記録し始める
一人ひとりがAIとの役割分担をどう段階的に深めていくかは、関連記事『AIとの協働とは?』で詳しく解説しています。
意思決定をAIに任せる前に読んでおきたい記事
支援・拡張・自動化の線引きは、仕組みを理解しただけでは決まりません。次の記事で、任せた後に起きる疲れや思考の空洞化、運用体制まで確認しておきましょう。
- 論点思考とは?ズレを防ぐ問いの設計と判断基準
AIに任せる前に、決めるべき論点を見極める判断軸 - AI疲れとは?判断と確認ばかり増える理由
判断と確認が増えるAI疲れを抑える対処パターン - 意思決定疲れとは?原因と対策・減らす方法
意思決定疲れを防ぐため、判断を仕組みに任せる設計法 - AIを使うと考えなくなるのは本当か?分岐点と習慣
AIに頼りすぎて考えなくなる分岐点を見分ける判断軸 - AIガバナンスとは?リスク管理と体制づくりの基本
少人数でも回せるAIガバナンス体制の実務手順